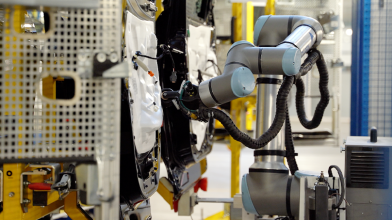
Cobot na linii, która się nie zatrzymuje: korekta wizyjna, sterowanie siłą i granice tego podejścia na przykładzie wdrożenia w Stellantis Tychy.
Koszyk
Cobot na linii, która się nie zatrzymuje: korekta wizyjna, sterowanie siłą i granice tego podejścia na przykładzie wdrożenia w Stellantis Tychy.
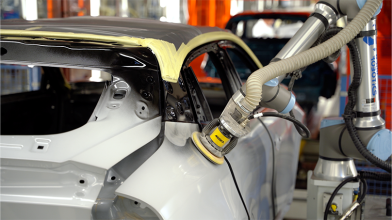
Jeśli rozważasz automatyzację szlifowania, polerowania albo gratowania i zastanawiasz się, czy wystarczy zaprogramować trajektorię, ten tekst pokazuje, gdzie leży granica sterowania pozycyjnego
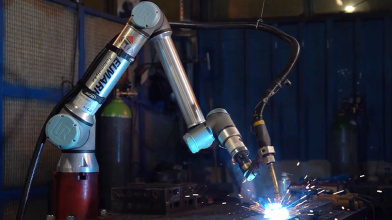
Zobacz, jak MCMS skróciło czas spawania o 30% dzięki cobotowi UR10e i SmoothTool. Ponad 30 programów, krótkie serie i praca na 2 zmiany.
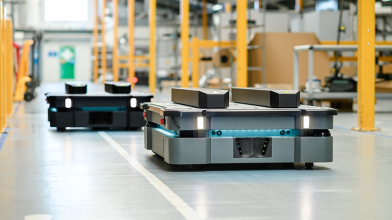
Sprawdź, jak roboty AMR automatyzują intralogistykę i transport wewnętrzny. Poznaj zastosowania robotów MiR oraz etapy wdrożenia krok po kroku.
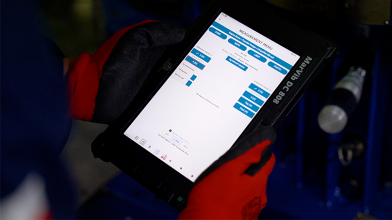
Getac ZX10/ZX80 ATEX w diagnostyce morskiej
Czas złożyć wszystko w jedną decyzję. W ostatniej części prowadzimy Cię ścieżką doboru stacji pod lokalne AI: od wzoru na rozmiar, przez gotowe scenariusze sprzętowe, po pełny stos. Pokazujemy też, dlaczego chmura ma swoje problemy, czyli nieprzewidywalne ceny, zależność od dostawcy i prywatność danych, i kiedy rachunek wychodzi po stronie rozwiązania lokalnego.
Każdy wat, który wchodzi do GPU, wychodzi jako ciepło, a to ciepło wyznacza realne granice projektu. W tej części omawiamy pobór mocy nowoczesnych akceleratorów, gęstość mocy w szafie rack i progi przejścia z chłodzenia powietrznego na ciecz oraz immersję, a także dobór form factoru: od bezwentylatorowego BoxPC na brzegu sieci po serwer w racku.
Najszybsze GPU stoi bezczynnie, jeśli dane nie docierają na czas. W tej części pokazujemy, jak dobrać pamięć masową i sieć pod lokalne AI: od dysków NVMe Gen5 i GPUDirect Storage, przez InfiniBand i Ethernet ze Spectrum-X, po pełny zestaw układów komunikacyjnych NVIDIA, czyli DPU BlueField, SuperNIC ConnectX i NVLink Switch.
Liczy GPU, ale to procesor, pamięć operacyjna i platforma decydują, czy karta dostanie dane na czas. W tej części, prowadzonej w duchu Intel-first, tłumaczymy, ile rdzeni i kanałów pamięci naprawdę potrzeba, czym jest akcelerator AMX do inferencji na CPU i jak dobrać platformę: od Core Ultra, przez Xeon w, po Xeon 6 i NVIDIA Grace.
GPU to serce stacji do AI i zwykle jej najdroższy element, a zarazem wybór, w którym najłatwiej przepłacić albo kupić kartę, która nie udźwignie modelu. W tej części pokazujemy, jak czytać specyfikację akceleratora pod inferencję i agentów: typy pamięci, architektury, formaty precyzji i pełną mapę układów NVIDIA, od stacji roboczych po centrum danych.